
L’été n’a pas ralenti l’écosystème. Depuis le début du mois d’août, trois sujets reviennent avec insistance, et ils racontent au fond la même histoire.
En bref :
- L’IA dans les équipes informatiques est rentable, et elle ne fait gagner de temps à presque personne. Sur 844 professionnels interrogés par SolarWinds, 84 % jugent le retour sur investissement atteint ou dépassé, et 71 % ne constatent aucune baisse de leur charge de travail. Le temps économisé d’un côté est repris de l’autre, en entretien et en relecture.
- VictoriaMetrics a corrigé fin août une faille d’authentification dans sa plateforme d’observabilité. Certaines adresses du produit répondaient sans demander le mot de passe. Si vous utilisez cet outil, la mise à jour est la priorité du mois, avant tout le reste.
- On arrête de parler de résilience, on commence à la mesurer. Plusieurs éditeurs publient la même idée en septembre : ce qui compte n’est plus le taux de disponibilité affiché, c’est ce que vivent vos utilisateurs pendant la panne, et le temps qu’il faut pour comprendre.
Un mot sur le vocabulaire, parce qu’il change dans ces pages comme il change dans le métier. On disait supervision quand la question était de savoir si un serveur répondait ou non. On dit observabilité depuis qu’il faut aussi comprendre pourquoi il se comporte comme il le fait, et ce que cela change pour ceux qui s’en servent. C’est le sujet de cette édition.
L’IA est rentable, et personne ne travaille moins
Commençons par le chiffre qui a fait le tour du secteur. SolarWinds a publié le 18 août son étude annuelle sur la gestion des services informatiques, menée auprès de 844 professionnels en Amérique du Nord, en Europe et en Asie-Pacifique, puis en a détaillé les résultats le 8 septembre. Le titre de l’éditeur parle d’un « écart entre le potentiel de l’IA et ce qu’elle rapporte vraiment », et les chiffres sont plus intéressants que le titre.
Source : étude 2026 State of ITSM, SolarWinds, publiée le 18 août, détaillée le 8 septembre.
D’un côté, la rentabilité est là : 84 % des répondants estiment que le retour sur investissement de l’IA est atteint ou dépassé. Sur les tâches précises, les gains sont mesurables : environ 3,3 heures par semaine sur la détection des incidents, 2,7 heures sur leur résolution. De l’autre côté, 52 % déclarent que leur charge de travail a augmenté depuis l’adoption de l’IA, et 19 % qu’elle est restée stable. Autrement dit, 71 % des équipes ne travaillent pas moins.
Où passe le temps gagné ? L’étude le dit assez précisément : 83 % des répondants consacrent au moins trois heures par semaine à l’entretien de leurs outils d’IA, et 44 % au moins six heures. Dans le détail, 48 % passent du temps à administrer ces outils, et 47 % à relire et valider ce qu’ils produisent. Le travail n’a pas disparu, il a changé de nature. On ne cherche plus l’anomalie, on vérifie que la machine chargée de la chercher ne se trompe pas.
Les trois dérives qu’il décrit méritent d’être connues, parce qu’aucune ne ressemble à une panne. D’abord, un modèle qui se dégrade sans le dire : sa justesse sur une tâche donnée tombe de 84 % à 51 % d’une version à l’autre, sans que personne ne l’annonce. Ensuite, une fuite d’informations : pour garder la trace de ce qui se passe, on enregistre la question entière envoyée au modèle, et donc parfois du code maison. Enfin, une facture qui augmente pendant des semaines avant que l’on découvre que le système repose sa question en boucle. Aucun des trois ne déclenche d’alerte sur un tableau de bord classique, et tous les trois coûtent cher.
On ne cherche plus l’anomalie, on vérifie que la machine qui la cherche ne raconte pas n’importe quoi.
C’est exactement ce que décrit New Relic dans un billet publié le 9 septembre, l’un des plus concrets que nous ayons lus cette année sur le sujet. L’éditeur y raconte comment il a équipé de mesures un « routeur » de modèles de langage, le petit logiciel qui décide, pour chaque question posée, quel modèle d’IA va y répondre. Son constat : les outils d’observabilité classiques savent répondre à la question « le service est-il debout », pas à la question « le routeur prend-il de bonnes décisions ». Sans mesures prévues à cet effet, ce composant est une boîte noire qui choisit seule, sans qu’on sache sur quels critères, ni ce que cela coûte.
Diana Todea, chez VictoriaMetrics, défend une position très proche dans un billet du 12 août sur la détection automatique des anomalies. Son idée est simple, et elle vaut bien au-delà de son produit : un modèle qui signale une anomalie n’a de valeur que si l’équipe peut vérifier sur quoi il se fonde et la confronter à ce qu’elle sait du terrain. Sans cet ancrage, on remplace une alerte qu’on ne comprend pas par une autre, plus sophistiquée, qu’on ne comprend toujours pas.
Autre évolution de ces six semaines, ces agents obtiennent le droit d’agir, et plus seulement de conseiller. Les notes de version de New Relic du mois d’août ajoutent à son agent Autopilot une intégration GitHub et des actions d’automatisation vers Jira et Ansible. En clair, l’agent ne se contente plus de rédiger un diagnostic : il peut ouvrir un ticket, proposer une correction dans le code, lancer une procédure automatisée sur les serveurs. Chez SolarWinds, la plateforme d’agents SW1 lancée au printemps va dans le même sens, au point que son principal artisan, Cullen Childress, vient d’être nommé directeur général par intérim.
Pour une direction informatique, la conséquence est simple à formuler et moins simple à mettre en œuvre : l’IA employée dans l’exploitation informatique est devenue une dépense récurrente, et un travail à part entière. Il faut la budgéter comme telle, avec le temps d’entretien et de relecture qu’elle consomme, et il faut pouvoir observer ce qu’elle fait. Un agent autorisé à écrire dans Jira, dans GitHub et dans Ansible mérite au moins autant de traçabilité qu’un administrateur humain.
Qui observe l’observateur
L’alerte de sécurité la plus sérieuse de ces six semaines est passée presque inaperçue. Le 28 août, VictoriaMetrics, l’outil qui stocke les mesures collectées sur vos infrastructures, très répandu dans les architectures modernes, a publié les versions v1.151.0 et v1.148.3 avec un correctif d’authentification. Le problème : le mot de passe censé protéger l’accès pouvait être contourné sur certaines adresses du produit, celles qui se terminent par /config ou /reload. L’exemple donné par l’éditeur est parlant : une requête vers /api/v1/import/prometheus/config arrivait jusqu’au composant qui reçoit les données, sans qu’on lui demande le moindre identifiant. Quatre composants sont touchés, ceux qui reçoivent les données comme ceux qui les restituent.
Il faut mesurer ce que cela représente. Un outil d’observabilité voit tout le système d’information, c’est sa raison d’être. Une porte d’entrée non authentifiée sur le composant d’ingestion, c’est la possibilité d’injecter de fausses métriques, donc de rendre aveugle la surveillance elle-même, au moment précis où on en a besoin. La consigne est directe : si VictoriaMetrics tourne chez vous, passez en v1.151.0, ou en v1.148.3 si vous suivez la branche à support long, celle qui privilégie la stabilité. Si le produit est exposé au-delà de votre réseau interne, faites-le cette semaine.
Ce n’est pas le seul correctif de ce genre sur la période. Fin juillet, la version v1.149.0 avait déjà verrouillé deux adresses qui permettaient d’effacer des données, pour bloquer un type d’attaque où un inconnu fait exécuter sa requête par un serveur de confiance. Et le 17 août, les versions v1.150.0 et v1.148.2 ont été reconstruites sur Go 1.26.6, à la suite des dix correctifs de sécurité publiés par l’équipe du langage Go les 11 et 13 août. Ce dernier point mérite qu’on s’y arrête, pour une raison qui dépasse VictoriaMetrics : quand une faille est corrigée dans un langage de programmation, tous les logiciels écrits avec doivent être recompilés et republiés. L’éditeur l’a fait en moins de deux jours. C’est un critère de maturité qu’on gagnerait à regarder plus souvent que la liste des fonctionnalités.
Un mot, enfin, sur une alerte qui a circulé en août et qui n’existait pas. Plusieurs sites ont relayé onze vulnérabilités corrigées dans Zabbix, dont deux de gravité élevée. Nous avons vérifié à la source : le registre officiel des bulletins de sécurité Zabbix ne contient rien depuis le 6 mai 2026. Ni en août, ni en septembre. Nous ne relayons donc pas cette alerte. Si quelqu’un vous l’a transmise, elle ne correspond à aucune publication de l’éditeur, et le réflexe qui a permis de le savoir tient en une phrase : pour une faille de sécurité, la seule source qui compte est celle de l’éditeur.
On arrête de parler de résilience, on commence à la mesurer
Troisième sujet, plus discret, et il rejoint les deux premiers. Plusieurs éditeurs ont publié en août et en septembre des textes qui disent la même chose avec des mots différents : la disponibilité affichée ne prouve rien, ce qui compte est ce que vit l’utilisateur pendant l’incident.
IP-Label a été le plus explicite. Dans un billet du 2 septembre, l’éditeur défend une idée simple : la résilience, ce n’est pas l’absence de panne, c’est la capacité à comprendre la perturbation, à en limiter les effets et à maintenir les services qui comptent. Il distingue au passage deux notions qu’on confond souvent en ce moment : la souveraineté numérique, qui porte sur le contrôle des données et de l’infrastructure, et la résilience opérationnelle, qui porte sur le comportement du service pendant la panne. Une technologie souveraine n’est pas à l’abri d’une panne. Le cycle qu’il propose tient en cinq temps : détecter, diagnostiquer, répondre, rétablir, améliorer. Et la méthode de mesure est classique mais exigeante : observer les vrais utilisateurs, et rejouer en permanence les parcours critiques de bout en bout.
VictoriaMetrics aborde le même sujet sous un autre angle, avec un billet du 11 septembre au titre bien choisi, « la demi-heure la plus chère d’un incident ». Cette demi-heure, c’est celle du diagnostic, le moment où personne ne sait encore où regarder. C’est précisément ce que la mesure de la résilience cherche à raccourcir, et c’est aussi là que les outils d’IA promettent le plus, ce qui nous ramène au premier sujet.
Même préoccupation, sur un terrain plus technique. Paessler a annoncé le 9 septembre que sa sonde multi-plateforme PRTG abandonne NATS au profit de QUIC, le protocole de transport moderne qui sert notamment au web. Deux bénéfices revendiqués, et les deux parlent de résilience. Le premier est une réduction de la surface d’attaque : plus besoin d’héberger, de corriger et de maintenir un serveur NATS dédié, donc un composant de moins à surveiller. Le second est la tenue sur les liaisons instables, avec un intérêt explicite pour les sites mobiles, navires et liaisons satellite, où une connexion qui change d’adresse ne coupe plus la collecte. Pour les équipes concernées, deux points d’attention : la communication passe sur le port 23563 en UDP, avec un repli en TCP, et il faudra rejouer l’assistant de configuration pour générer un nouveau jeton. La cible annoncée est PRTG 126, d’ici la fin de l’année.
Et aussi
Centreon a livré ses mises à jour avec une régularité de métronome : la série 25.10 le 2 septembre, la 24.10 le 3, le module de cartographie le 10. Point de calendrier utile à noter dans vos plans : la version 25.10 est supportée jusqu’en avril 2027, et la 24.10, qui est une version à support long, jusqu’en octobre 2027. Si vous êtes resté en 24.04, elle est hors support depuis avril 2026. Zabbix a livré ses correctifs 7.4.14 et 7.0.30 le 25 août, puis a détaillé le 9 septembre une série d’améliorations de son offre cloud, dont la possibilité d’installer ses relais de collecte directement chez l’hébergeur, sans avoir à fournir de machine. Le Zabbix Summit se tiendra à Riga les 8 et 9 octobre. New Relic a ouvert sa région japonaise le 31 août et publié le 11 septembre une réflexion intéressante sur les raisons pour lesquelles OpenTelemetry, le standard ouvert de l’observabilité, s’est imposé : moins par neutralité vis-à-vis des éditeurs que parce qu’il donne aux équipes plateforme un contrat clair à proposer aux développeurs. M81 annonce son programme de webinars du second semestre, dont un sur la haute disponibilité IBM i comparée aux stratégies de snapshots, et sera présent à Navigate du 26 au 29 octobre.
Transparence habituelle sur les silences : Mr Suricate n’a rien publié depuis le 20 juillet. Martello a publié le 13 août ses résultats trimestriels, en repli de 7 % à 2,87 M$ mais repassés en bénéfice net, et n’a rien annoncé en septembre ; l’éditeur poursuit son recentrage sur le segment Mitel après la fin de commercialisation de Vantage DX.
À noter dans les agendas
- 8 et 9 octobre : Zabbix Summit à Riga, formations certifiées du 13 au 17.
- 15 octobre : notre meet-up à Nantes, avec VictoriaMetrics.
- 26 au 29 octobre : Navigate, avec l’équipe M81.
- D’ici fin 2026 : PRTG 126 et la bascule de la sonde multi-plateforme vers QUIC, à anticiper côté règles de pare-feu.
- Avril 2027 : fin de support de Centreon 25.10. Octobre 2027 pour la 24.10.
Notre meet-up du 15 octobre, à Nantes
Une parenthèse, dans le prolongement direct de ce qui précède. Nous organisons un meet-up le jeudi 15 octobre 2026, de 18h00 à 20h00, à Nantes, autour de l’observabilité. Diana Todea, Head of Developer Relations Engineering chez VictoriaMetrics, y interviendra à distance sur VictoriaMetrics Cloud et les nouveautés de la plateforme. C’est elle qui signait, le 12 août, le billet sur la détection d’anomalies cité plus haut dans cette édition : l’occasion de lui poser directement les questions que ce genre de texte laisse ouvertes.
Sensor Factory est partenaire revendeur de VictoriaMetrics. Ce partenariat repose sur des déploiements en production chez nos clients, et non sur un simple accord commercial : c’est ce qui nous permet d’en parler avec précision. Selon le contexte, nous fournissons la plateforme, ou nous intervenons sur l’outil déjà en place.
Le format est volontairement accessible : profils techniques et non techniques mélangés, aucun prérequis. Si l’observabilité n’est pas votre quotidien, cette soirée est construite pour vous aussi. L’adresse exacte et le programme détaillé seront communiqués sous peu. Pour être prévenu en premier, ou simplement nous dire que vous comptez venir, écrivez-nous.
Ce qu’il faut retenir
- Budgétez l’entretien de l’IA, pas seulement sa licence. Trois à six heures par semaine et par personne, c’est l’ordre de grandeur mesuré. Une IA d’exploitation qu’on installe sans prévoir ce temps produit de la déception, pas des économies.
- La priorité technique du mois est la mise à jour de VictoriaMetrics. v1.151.0, ou v1.148.3 sur la branche à support long. Le reste peut attendre la semaine prochaine, pas cette mise à jour.
- Vérifiez les alertes de sécurité à la source. Les onze failles Zabbix d’août n’ont jamais existé. Le registre officiel de l’éditeur est vide depuis le 6 mai, et c’est la seule référence qui compte.
Chez nous : SenHub Agent 0.5.5 et Toise
Nos deux projets open source sont nativement compatibles OpenTelemetry. SenHub Agent collecte les données, infrastructures et bases de données comprises, de façon standardisée et portable : elles restent les vôtres, sans verrou propriétaire. Toise cartographie les entités de votre système d’information et leurs dépendances, avec leur historique, et répond à la question d’impact : si ce composant tombe, ou si un agent le modifie, qu’est-ce que cela affecte ? Les trois sujets de cette édition nous ont occupés aussi.
La console devient un vrai poste de configuration. C’est le gros du travail de la 0.5.5, en bêta depuis le 10 septembre, et cela change concrètement le travail de ceux qui exploitent l’agent. Jusqu’ici, déclarer une sonde passait par un fichier de configuration. Désormais on la crée, on la modifie et surtout on la teste depuis l’interface : l’agent valide la configuration, lance une collecte d’essai et montre le résultat avant d’enregistrer quoi que ce soit. L’écran dit aussi pourquoi une sonde échoue et quelles destinations ne reçoivent plus rien, au lieu de laisser deviner. Chaque sonde et chaque destination déclare maintenant le schéma de ses paramètres, avec ce qui est indispensable au démarrage et ce qui ne l’est que dans certains cas, ce qui permet à l’interface de guider au lieu d’exiger un manuel.
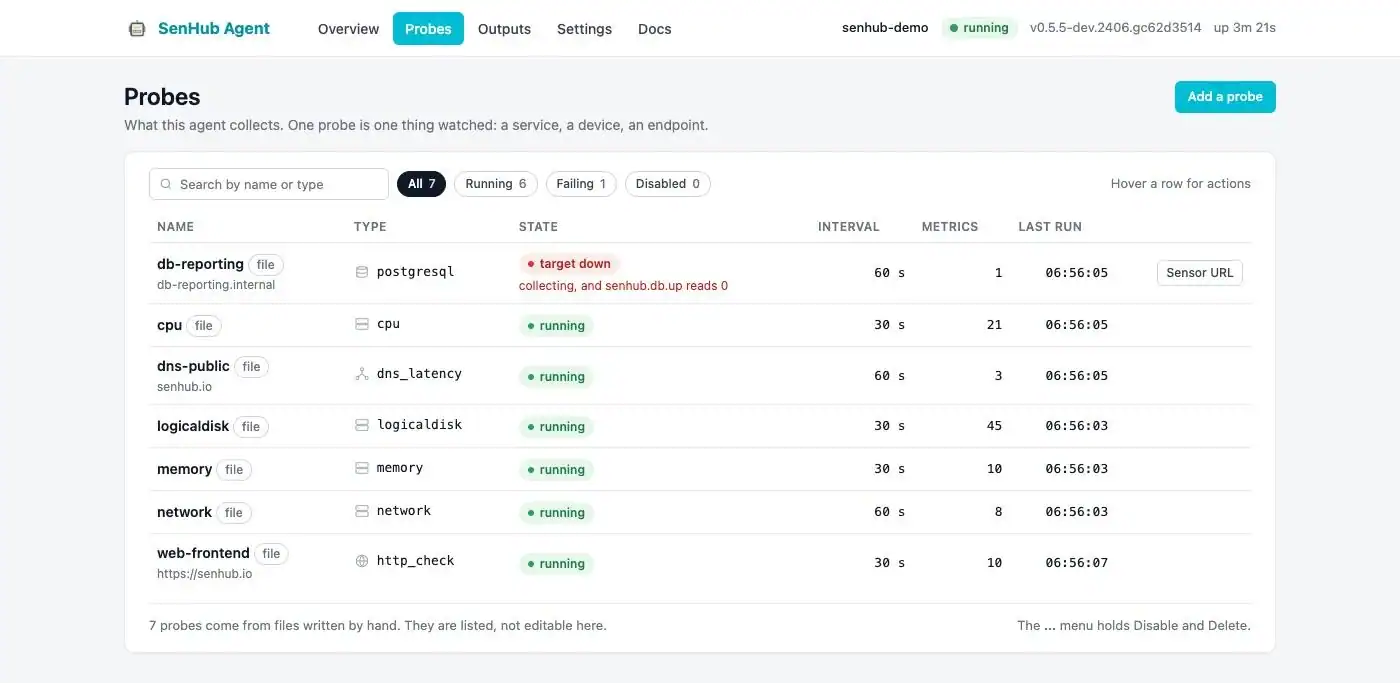
Une gouvernance attachée à chaque sonde. L’autre nouveauté de la 0.5.5 intéressera surtout les organisations qui supervisent pour le compte de plusieurs entités, filiales, clients ou métiers. On peut désormais poser un bloc de gouvernance sur chaque instance de sonde, et cette information est estampillée sur les mesures, les journaux et les entités que la sonde observe. Dans la même veine, le propriétaire et la localisation déclarés sur une machine descendent automatiquement sur tout ce qu’elle exécute. Autrement dit, la réponse à « à qui appartient cette donnée, et où a-t-elle été produite » ne se reconstitue plus après coup, elle voyage avec la donnée.
Dans l’édition Enterprise, les sondes payantes ont gagné début septembre une sonde azure_container_apps qui récupère le flux de journaux d’une application conteneurisée chez Azure. Le travail intéressant n’est pas la collecte elle-même mais ce qui l’entoure : filtrage des lignes à la source pour ne pas transporter ce qu’on jettera, publication de ce qu’il reste du budget d’appels Azure, temporisation quand la plateforme refuse, et recul automatique devant un conteneur qui redémarre en boucle. Une sonde qui sature l’API d’un fournisseur crée le problème qu’elle était censée détecter.
La même chaîne de correctifs Go que les autres. Quand l’équipe du langage Go a publié ses dix correctifs de sécurité les 11 et 13 août, nous avons reconstruit l’agent dessus et livré la 0.5.4 le 18 août. La 0.5.3 du 3 août avait terminé la signature des installeurs Windows, et le travail en cours pour la version finale ajoute la liste des composants tiers embarqués, générée depuis la compilation au lieu d’être tenue à la main. Pour une direction informatique, c’est ce qui permet de répondre sans enquête à la question « qu’est-ce qui tourne exactement sur nos serveurs ».
Toise : une réponse qui dit ce qu’elle ne sait pas. C’est l’évolution dont nous sommes le plus satisfaits ce mois-ci, et elle répond directement au problème décrit plus haut par New Relic. Depuis la version 0.16.0, publiée le 1er septembre, chaque réponse que Toise donne à un agent d’IA déclare son propre périmètre et sa fraîcheur : sur quoi elle porte, et de quand elle date. Un agent qui interroge la cartographie sait donc ce qu’il ignore, au lieu de conclure sur une vue partielle sans s’en apercevoir. C’est une condition simple, et rarement remplie, pour laisser un agent travailler sans le surveiller en permanence. Sur la même période, la cartographie a appris à représenter les pods Kubernetes et les segments réseau avec leurs rattachements, les durées de conservation se règlent client par client, et l’audit qui prépare le gel de l’interface avant une version 1.0 est ouvert. Le vocabulaire d’entités continue de suivre les travaux « Resources and Entities » d’OpenTelemetry, plutôt qu’un format maison.

Ce que nous en faisons chez Sensor Factory
Concrètement, sur cette période, nous avons traité la mise à jour VictoriaMetrics chez les clients concernés, vérifié les versions Centreon au regard des dates de fin de support, et commencé à documenter avec plusieurs directions informatiques un cadre simple pour ces agents : ce qu’ils ont le droit de faire, un journal de ce qu’ils modifient, et un humain qui valide toute action qui change quelque chose. Rien de spectaculaire, mais c’est ce qui fait la différence entre un agent utile et un agent dont personne ne consulte les traces.
Si vous voulez faire le point sur votre propre parc, correctifs prioritaires, calendrier de fin de support ou encadrement des agents, parlons-en. Les éditions précédentes sont dans notre rubrique veille.
Pour les équipes techniques : le détail des versions
- VictoriaMetrics : v1.151.0 et v1.148.3 (28 août, publiées le 31 : correctif de contournement d’authentification HTTP Basic sur les chemins suffixés
/configet/reloadpourvmsingle,vmagent,vminsert,vmselect; écoute sur socket Unix via-httpListenAddr; jaugevm_app_prev_shutdown_uncleanet règle d’alerteUncleanShutdown; correctif d’une boucle infinie sur l’endpoint OpenTelemetry Firehose face à un varint incomplet) ; v1.150.0 et v1.148.2 (17 août : Go 1.26.6,-enableMultitenancyViaHeaderspar défaut, jusqu’à 30 % de CPU en moins sur le relabeling multi-conditions, découverte de services Linode) ; v1.149.0 (31 juillet :delete_seriesetdelSeriesen POST seulement, re-routage par lenteur actif par défaut survminsert) ; opérateur Kubernetes v0.74.1 (4 août), v0.75.0-rc1 (3 septembre) ; VictoriaLogs v1.51.1 (18 août). - Zabbix : 7.4.14 et 7.0.30 (25 août : version maximale de TimescaleDB portée à 2.29, correctifs frontend, agent 2 et modèles Redis, Ceph, RabbitMQ, Check Point NGFW). Aucune version en septembre à ce jour. Aucun bulletin de sécurité depuis le 6 mai.
- Centreon : train 25.10 le 2 septembre (
centreon-web-25.10.17,open-tickets-25.10.11,collect-25.10.12,gorgone-25.10.9,monitoring-agent-25.10.9,dsm-25.10.5) ; train 24.10 le 3 septembre (web-24.10.30,open-tickets-24.10.16,collect-24.10.24,gorgone-24.10.16,monitoring-agent-24.10.19,dsm-24.10.8) et extensions commerciales le même jour ;centreon-map24.10.22 et 25.10.10 le 10 septembre ;centreon-ha25.10.3 et 24.10.4 le 6 août. À noter sur GitHub, une ligne 26.x apparue le 4 août (26.07.0, hotfix 26.07.1 le 14 août) puis le 1er septembre (26.09.0), non documentée à ce jour sur le site de l’éditeur. Cycle de vie : 25.10 jusqu’en 04/2027, 24.10 LTS jusqu’en 10/2027, 24.04 hors support. - Paessler : PRTG 26.3.122 annoncé le 10 août (7 nouveaux capteurs dont IP Reputation Score, RDP Client-Side Check, WMI Microsoft SQL Server et REST JSON Data ; 10 capteurs sortis de bêta dont toute la famille Proxmox VE et les capteurs SSL/TLS ; durcissement XSS ; WSMAN par défaut sur les nouvelles installations) ; bascule de la sonde multi-plateforme vers QUIC annoncée le 9 septembre (authentification Ed25519, TLS 1.3, port 23563/UDP avec repli TCP, suppression des règles sur le port 23561, cible PRTG 126 fin 2026).
- New Relic : Google Cloud Platform Observability en disponibilité générale (4 août) ; Notebooks en disponibilité générale (11 août), même lot de notes que l’intégration GitHub d’Autopilot et les actions Jira et Ansible ; conférence RUNTIME à Atlanta (12 et 13 août) ; région Japon (31 août). Ground Truth n’est toujours pas en disponibilité générale.
- SolarWinds : étude 2026 State of ITSM (communiqué le 18 août, chiffres détaillés le 8 septembre, 844 répondants) ; succession à la direction générale annoncée le 26 août, départ de Sudhakar Ramakrishna effectif le 30 septembre, intérim assuré par Cullen Childress, Samuel Monti nommé directeur financier.
- SenHub Agent : 0.5.3 (3 août : signature des exécutables Windows, MSI reconstruit depuis l’exe signé) ; 0.5.4 (18 août : reconstruction sur Go 1.26.6, train OpenTelemetry aligné sur core 1.45/0.21) ; 0.5.5-beta (10 septembre : création, édition et test des sondes depuis la console avec validation et collecte d’essai, pages de destinations, diagnostic d’échec par sonde et par destination, bloc de gouvernance par instance estampillé sur métriques, journaux et entités, héritage du propriétaire et de la localisation depuis l’hôte, schéma de paramètres déclaré pour chaque sonde et chaque sortie avec marquage de ce qui est indispensable au démarrage, version TLS minimale effectivement appliquée à l’écoute, image conteneur démarrable avec une seule variable et ouverte à toutes les sondes). La liste des composants tiers générée depuis la compilation est sur la branche d’intégration, pas encore dans la bêta publiée. Édition Enterprise : sonde
azure_container_apps(flux de journaux d’une Container App, filtrage à la source, publication du budget d’appels ARM restant, respect des 429 et recul devant un conteneur en boucle de redémarrage). - Toise : v0.11.0 à v0.16.0 (11 août au 1er septembre) : type d’entité
pod,network.segmentavecattached_toethas_segment, bornes de rétention par client, réponses MCP déclarant leur périmètre et leur fraîcheur,entity.delete.reasonfigé au contrat, ouverture de l’audit de gel avant la 1.0. - Écosystème : Go 1.26.6 (10 correctifs de sécurité, 11 au 13 août) ; OpenTelemetry, conventions sémantiques v1.44.0 (4 août), spécification v1.60.0 (7 août), Collector v0.158.0 à v0.160.0 (4 août au 2 septembre).
Cette veille est mensuelle. La prochaine édition couvrira octobre 2026. Pour la recevoir automatiquement, l’inscription newsletter est en bas de page.