Gouverner, c’est prévoir. Pour une DSI, tout part de l’évolution des indicateurs de consommation de ressources : stockage, puissance de calcul, bande passante. À quelques jours, il s’agit de libérer de la place ou d’ajouter des ressources avant la panne. À quelques mois ou quelques années, de décider des investissements. Mistral AI affirme prévoir ces courbes mieux que tous ses concurrents avec Timestral, son modèle de prévision de séries temporelles (time series forecasting) publié le 15 octobre. Nous l’avons mis à l’épreuve sur nos propres serveurs, face aux méthodes que les DSI utilisent depuis des années. Voyons ce que ça donne.
Une IA qui prévoit des courbes qu’elle n’a jamais vues
La prévision de séries temporelles (time series) n’a pas attendu l’intelligence artificielle. Une série temporelle, c’est une métrique relevée à intervalle régulier : l’espace occupé sur un disque, la charge d’un processeur, le trafic d’un site. Pendant des décennies, on les a prolongées avec des méthodes statistiques, de la régression linéaire au lissage exponentiel de Holt-Winters, mis au point à la fin des années 1950, ou aux modèles ARIMA de Box et Jenkins, publiés en 1970. Chacune applique une formule réglée série par série. À partir de 2017, le machine learning a pris le relais avec des outils comme Prophet chez Facebook ou DeepAR chez Amazon, à condition de les entraîner sur les données de l’entreprise puis de les maintenir.
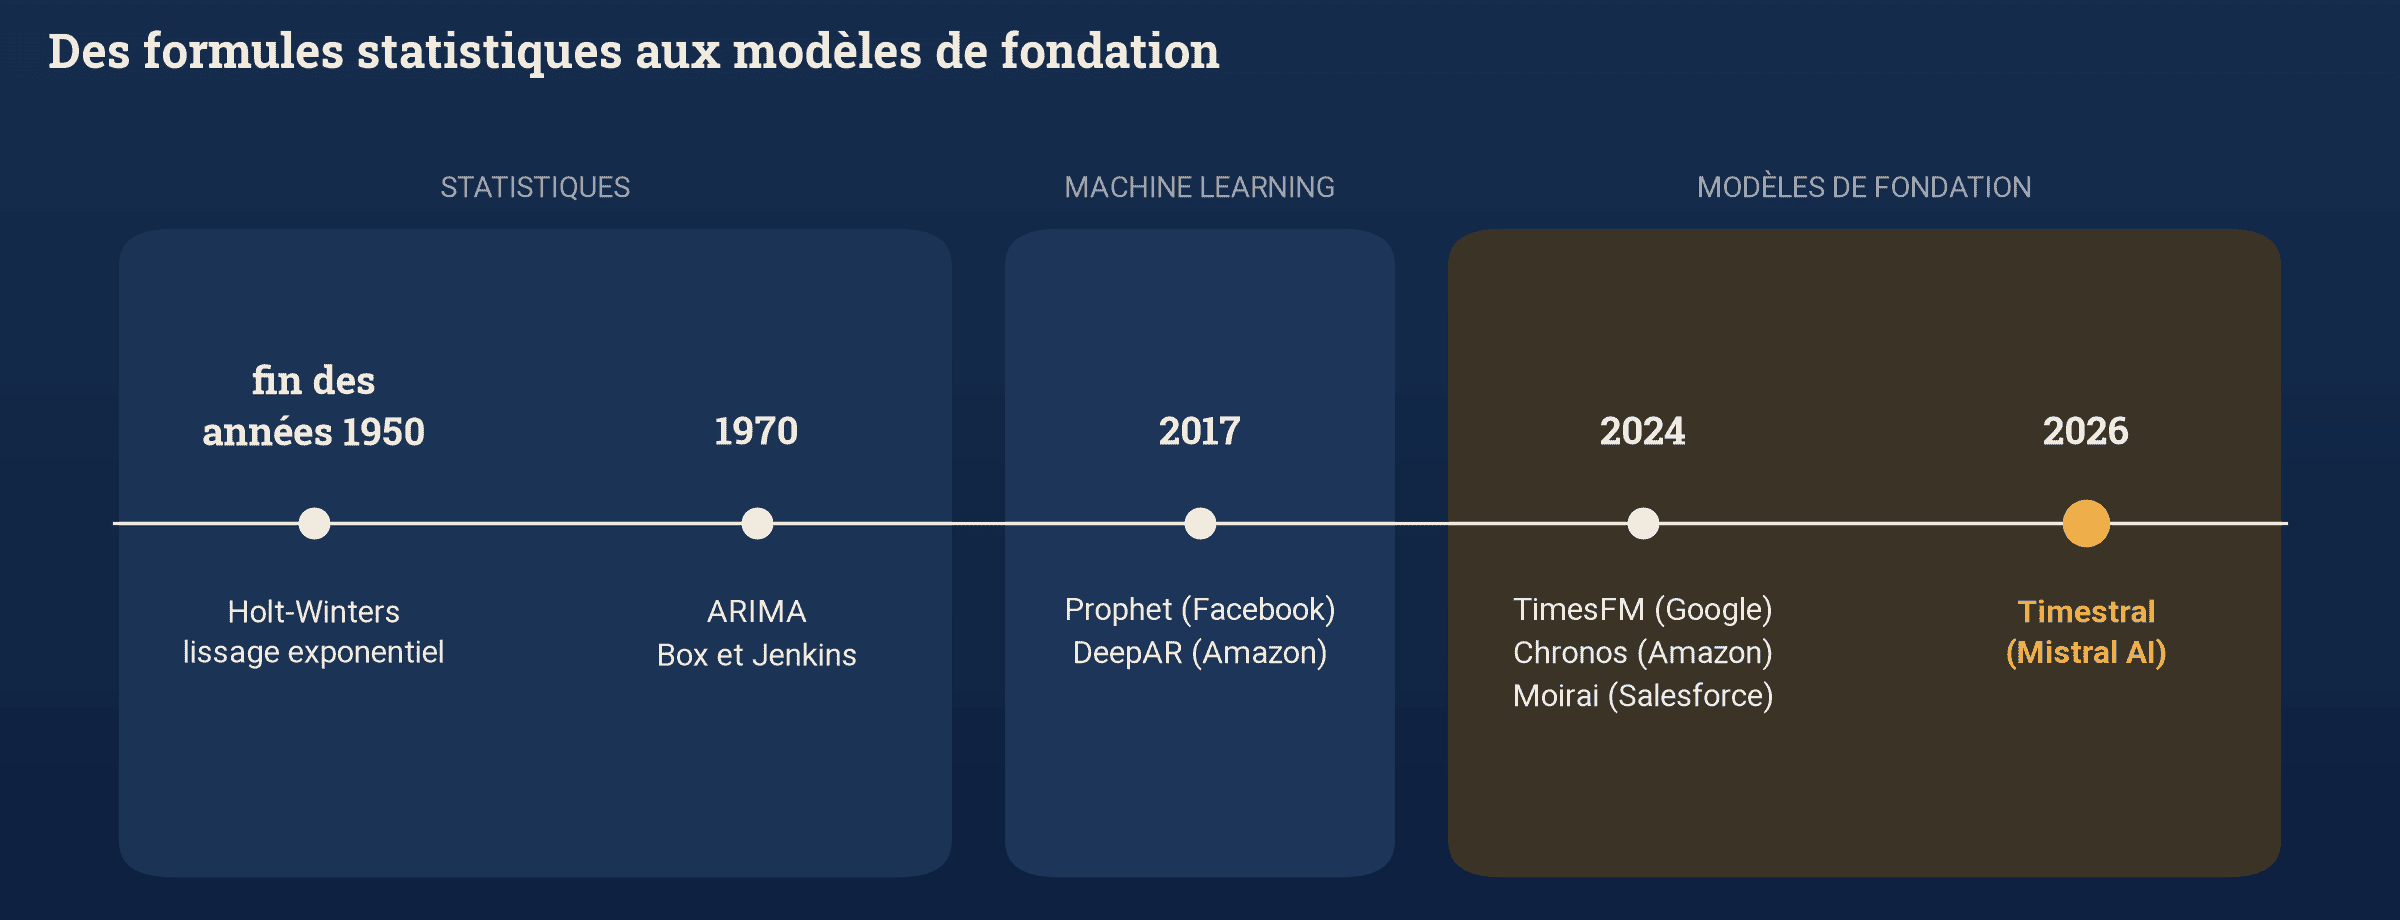
Depuis 2024, une troisième génération bouscule cet ordre. Google (TimesFM), Amazon (Chronos) et Salesforce (Moirai) ont repris l’architecture des grands modèles de langage, le transformer, et l’ont entraînée sur des milliards de points de mesure plutôt que sur du texte. Ces modèles de fondation fonctionnent en zero-shot : ils s’appliquent directement à une métrique qu’ils n’ont jamais vue, sans entraînement préalable.
Timestral est le dernier arrivé. Selon Mistral, il devance ses concurrents sur les trois benchmarks de référence du domaine, et il « n’a pas besoin de carte graphique ». Il existe en quatre tailles, de 5 à 209 millions de paramètres. Son code est sous licence Apache 2.0 et ses poids sont gratuits pour les entreprises dont le chiffre d’affaires mensuel reste sous 20 millions de dollars.
Sur le papier, la promesse est forte : un modèle qui n’a jamais vu vos serveurs prévoirait leur évolution mieux qu’une formule réglée sur eux. Nous avons voulu le vérifier sur les nôtres.
Le test : un mois de prévisions rejouées
Nous avons extrait trois mois de métriques horaires de nos propres serveurs : espace de stockage occupé, trafic web, nombre de requêtes reçues. Puis nous avons procédé à un backtest, la méthode classique pour évaluer une prévision. On se replace à une date passée, le modèle ne voit que l’historique antérieur, et l’on compare sa prévision à ce qui s’est réellement produit. Nous avons répété l’exercice chaque jour du 6 octobre au 2 novembre, à 24 heures, et chaque semaine depuis fin septembre, à sept jours. Timestral n’ayant jamais vu nos données, le fait que ces dates précèdent sa sortie ne change rien au résultat.
Face à lui, trois concurrents. Chronos-2, le modèle d’Amazon, dont la licence Apache 2.0 autorise l’usage commercial sans condition. La régression linéaire, qui prolonge la tendance des dernières heures ou des derniers jours, et que les outils de la famille Prometheus, dont VictoriaMetrics, proposent depuis des années sous le nom de predict_linear. Enfin, la prévision naïve, qui répète la veille à l’identique et sert d’étalon.
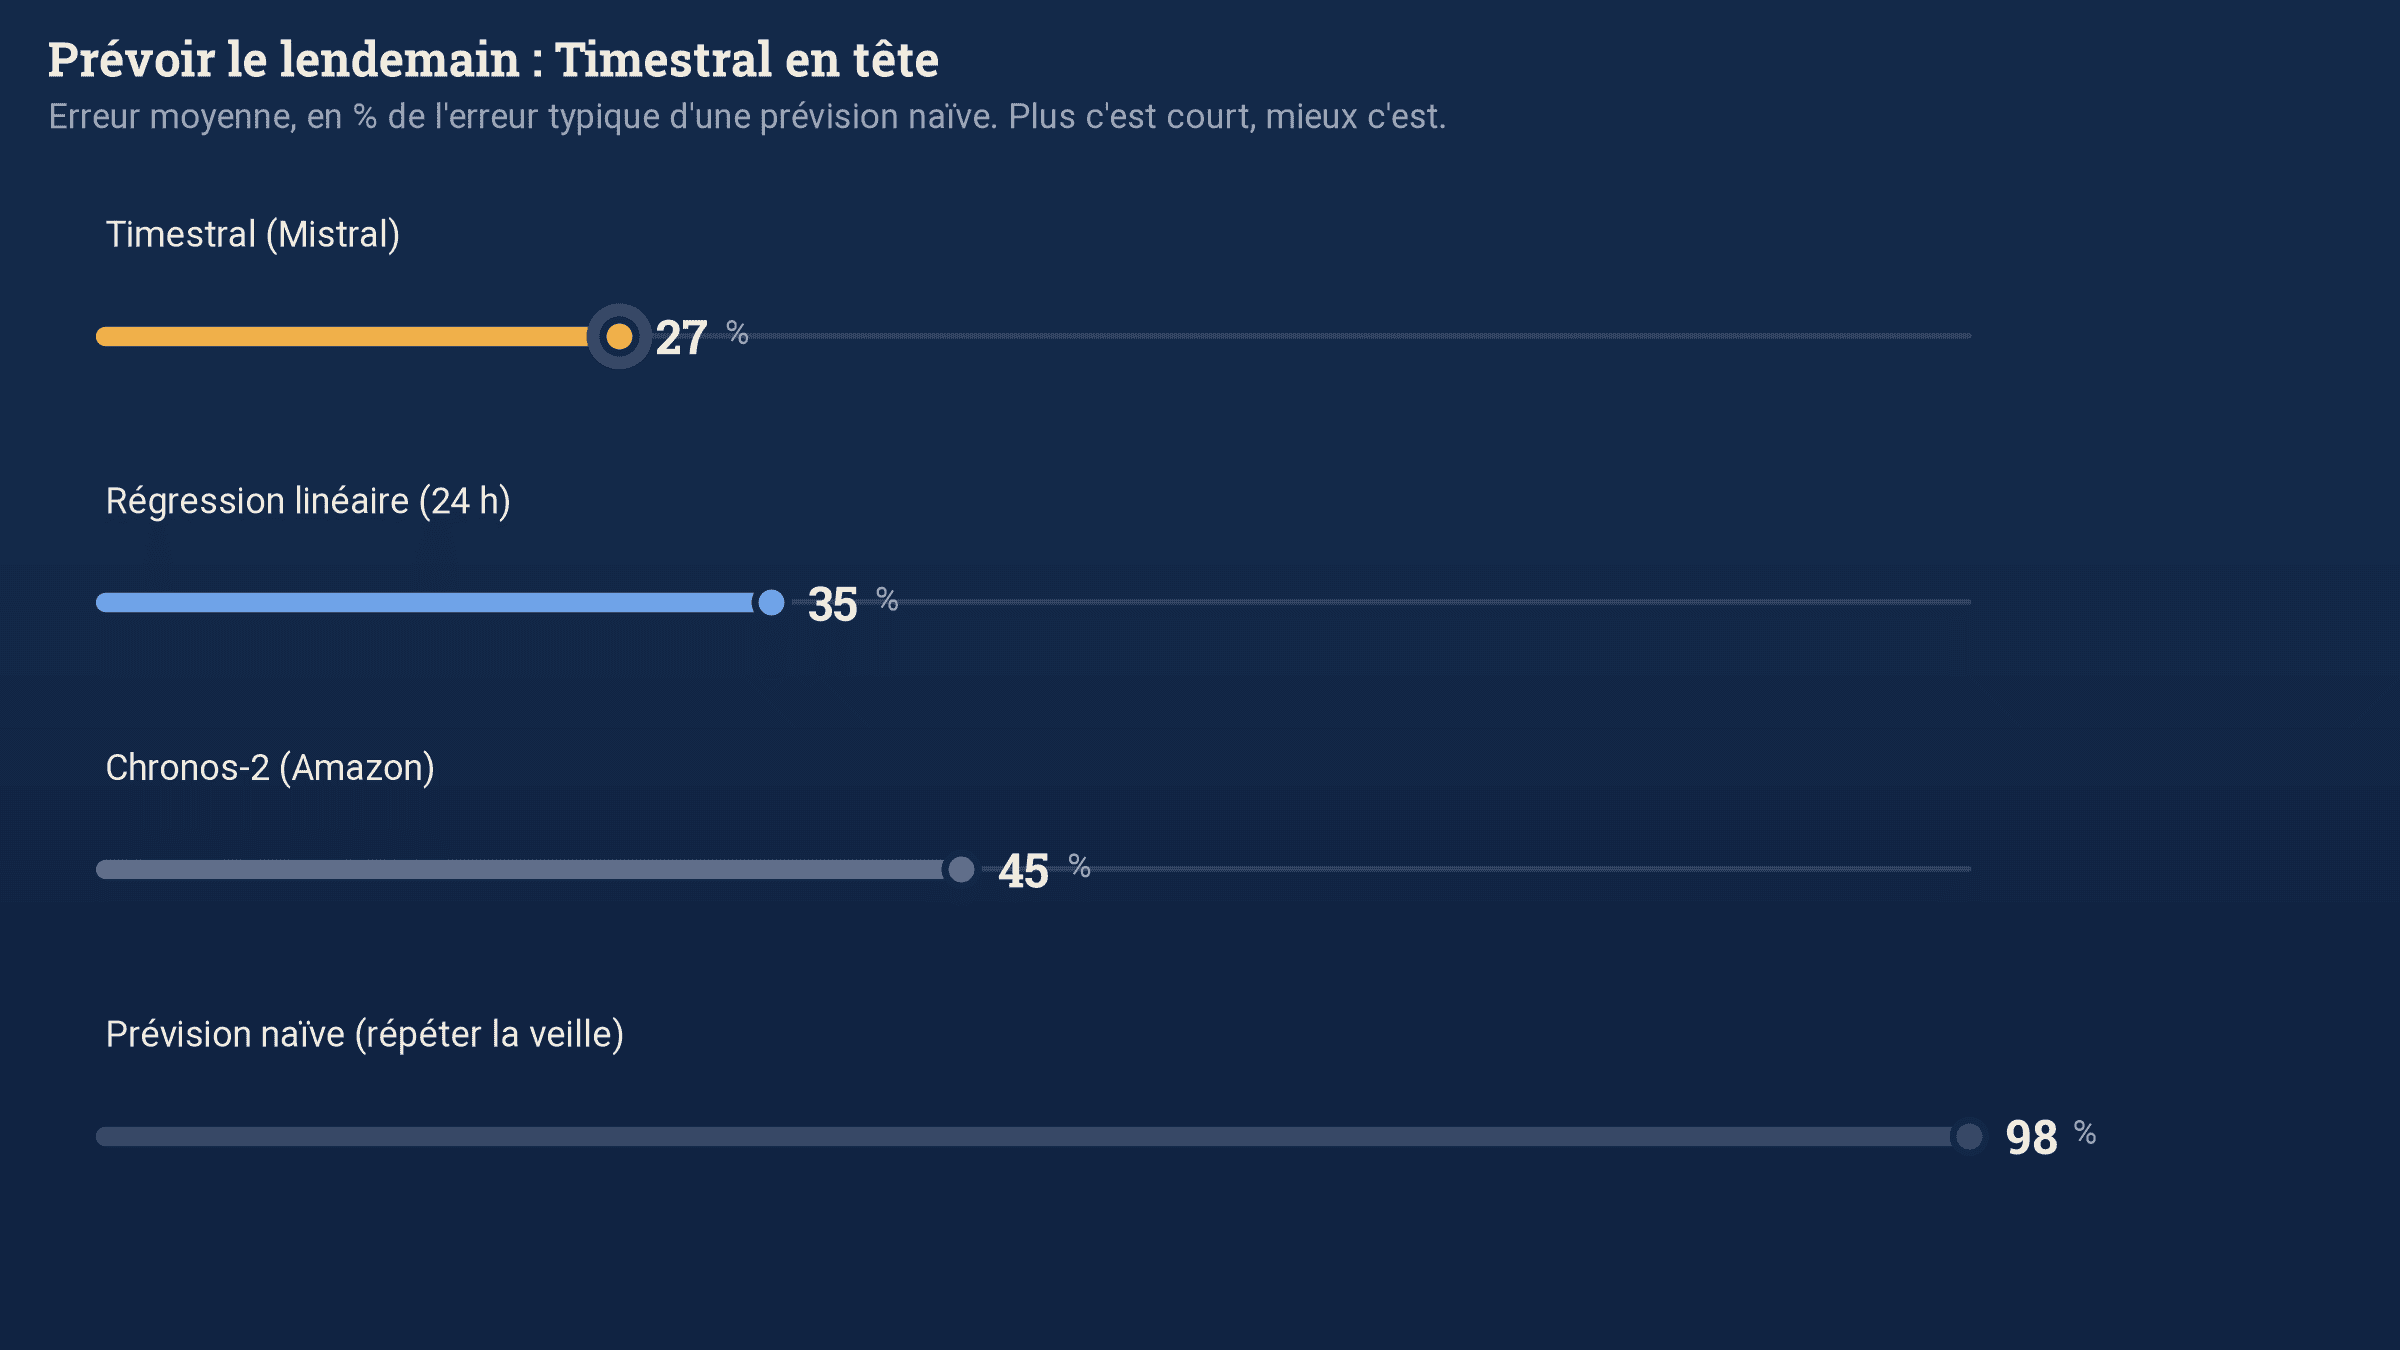
Sur la prévision du lendemain, Timestral tient sa promesse. Son erreur moyenne représente un peu plus du quart de celle de la prévision naïve. La régression linéaire fait un peu moins bien, Chronos-2 nettement moins bien. Sa version à 28 millions de paramètres fait jeu égal avec la plus grande et produit chaque prévision en trois centièmes de seconde, sur le processeur d’un Mac mini.
Restait la question qui intéresse vraiment une DSI. Connaître la valeur d’une métrique demain a peu d’intérêt en soi. Ce qui compte, c’est le jour où elle atteindra une limite.
Quand le stockage sera-t-il plein ?
Nous avons posé cette question aux quatre méthodes, sur le volume de données de nos deux serveurs de stockage. À 21 reprises, nous leur avons demandé à quel moment un seuil serait franchi, puis nous avons mesuré l’écart avec le moment réel.
Pour un seuil atteint le lendemain, toutes se trompent de quelques heures. Pour un seuil atteint une semaine plus tard, le classement s’inverse. En valeur médiane, la régression linéaire sur sept jours s’est trompée de 33 heures, Chronos-2 de 42 heures, Timestral de 45 heures. La plus ancienne des méthodes a battu la plus récente.
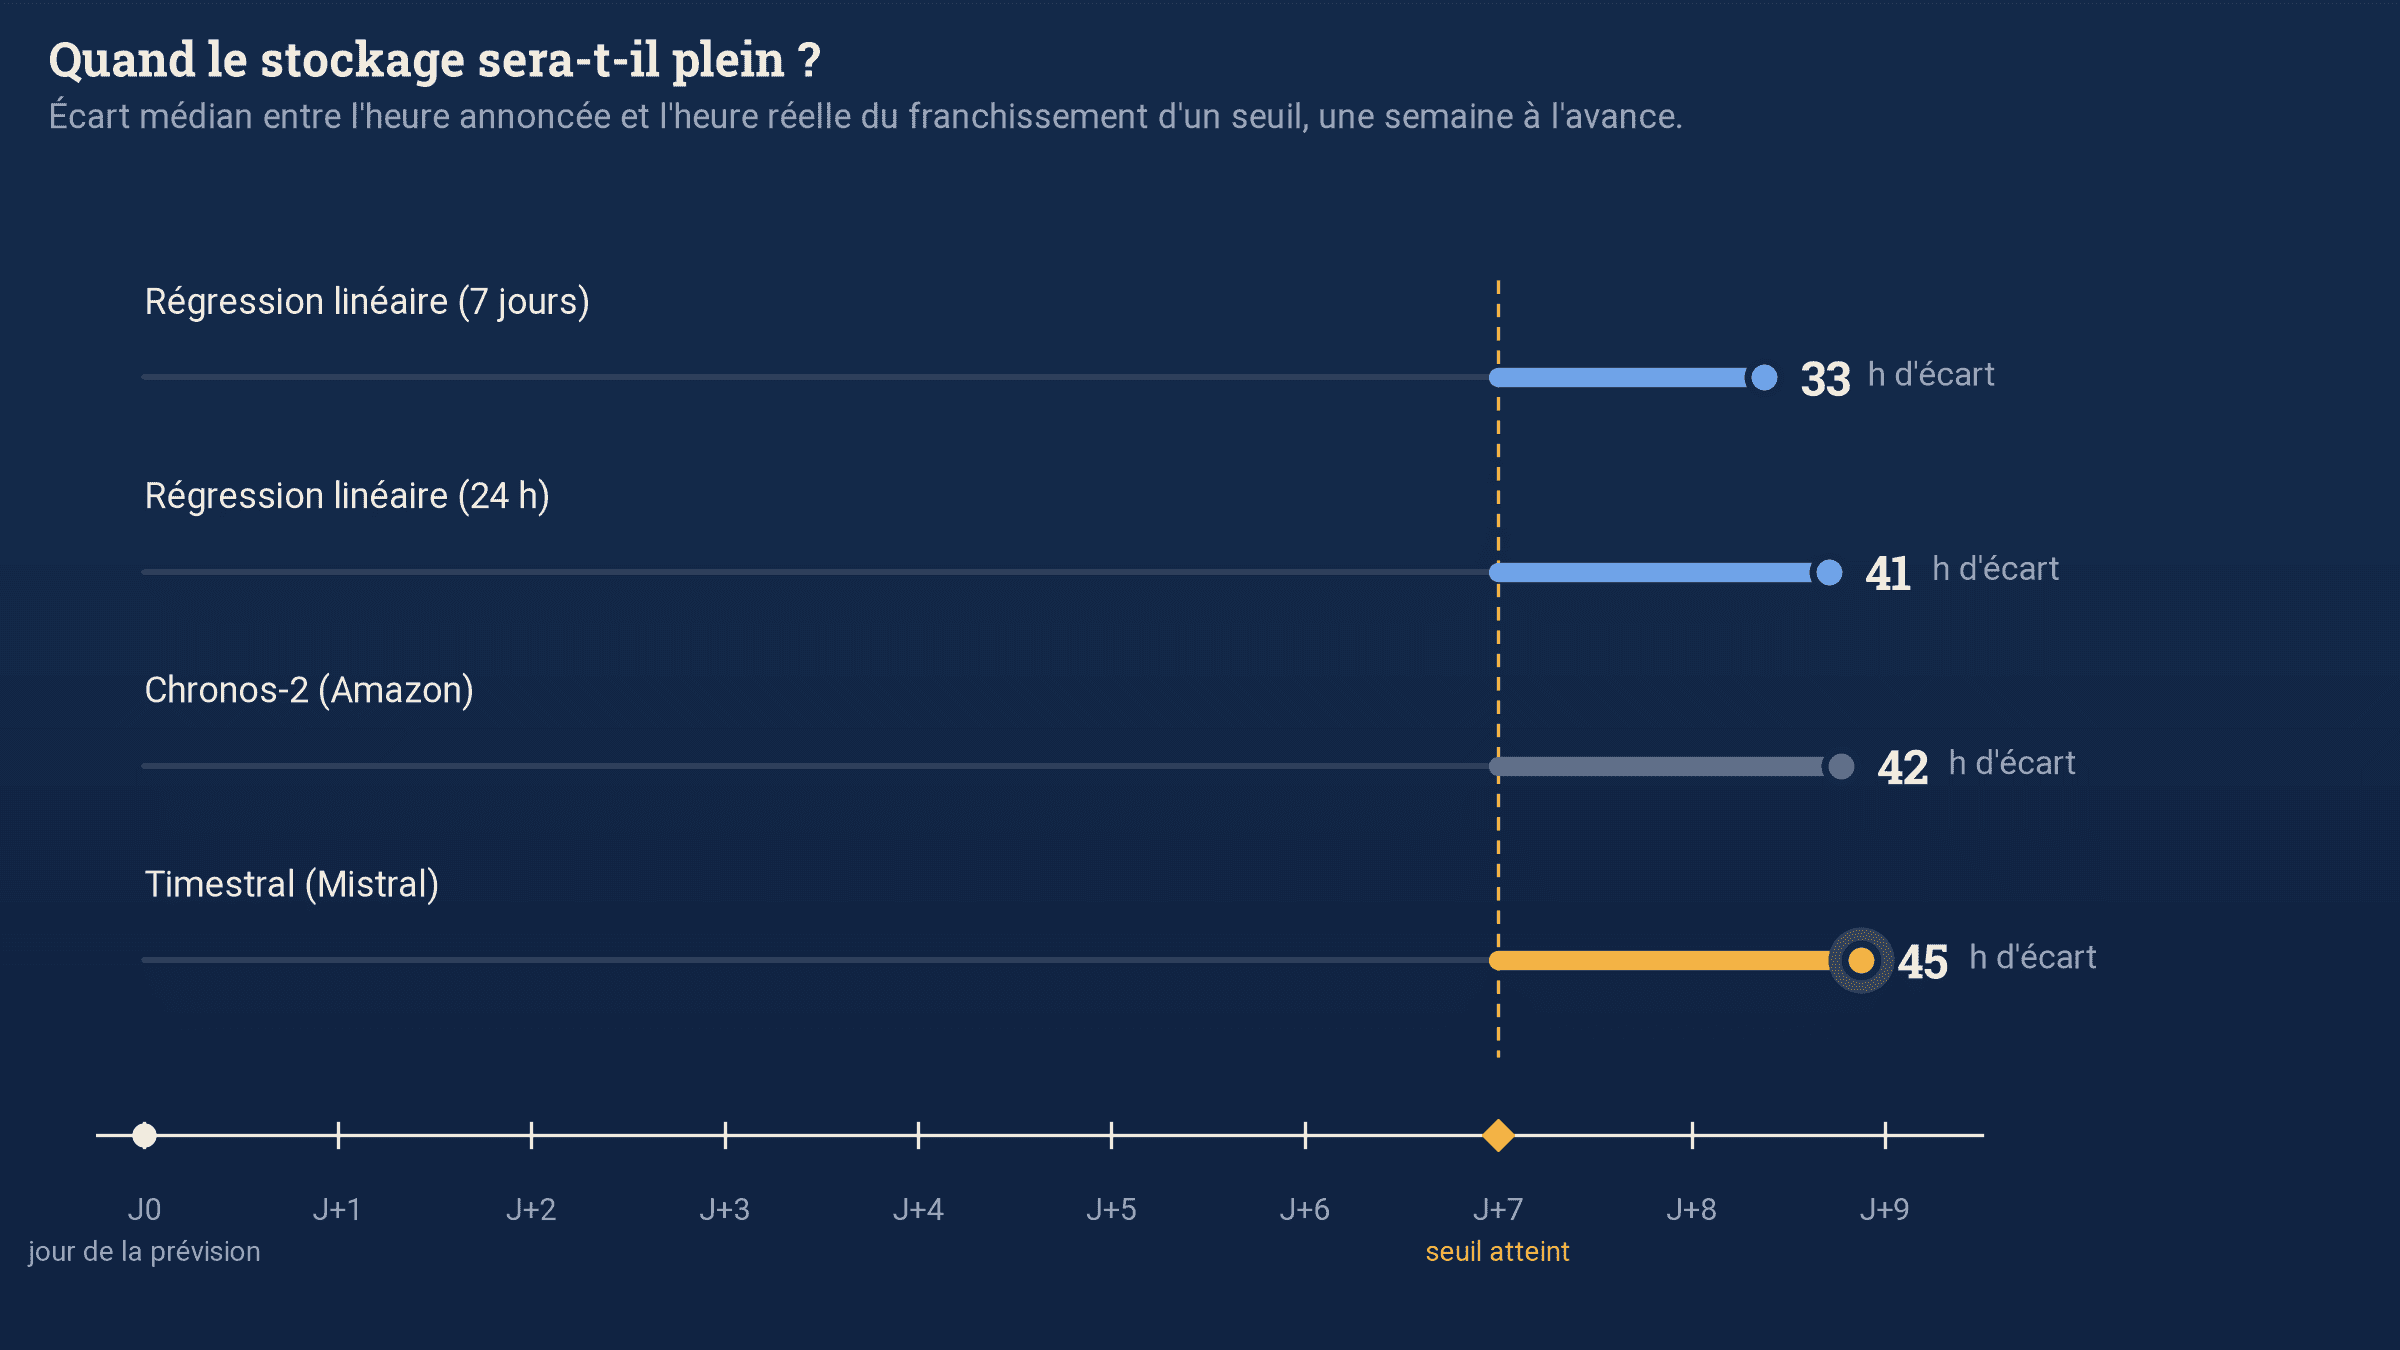
Timestral garde un avantage : il annonce toujours le franchissement, alors que la régression calculée sur les seules 24 dernières heures ne l’a pas vu venir dans 12 % des cas. Mais toutes les méthodes ont annoncé le seuil trop tard.
Pour comprendre pourquoi tous arrivent en retard, il faut regarder une journée précise.
Le 28 octobre, 13 000 nouvelles séries en une heure
Ce jour-là, le nombre de séries suivies par notre infrastructure a augmenté d’environ 13 000 d’un coup, et le volume stocké sur l’un de nos serveurs a fait un bond de 400 mégaoctets en une heure. Aucune méthode ne l’avait prévu. Aucune ne pouvait le prévoir : rien dans l’historique de la courbe n’annonçait cette arrivée.
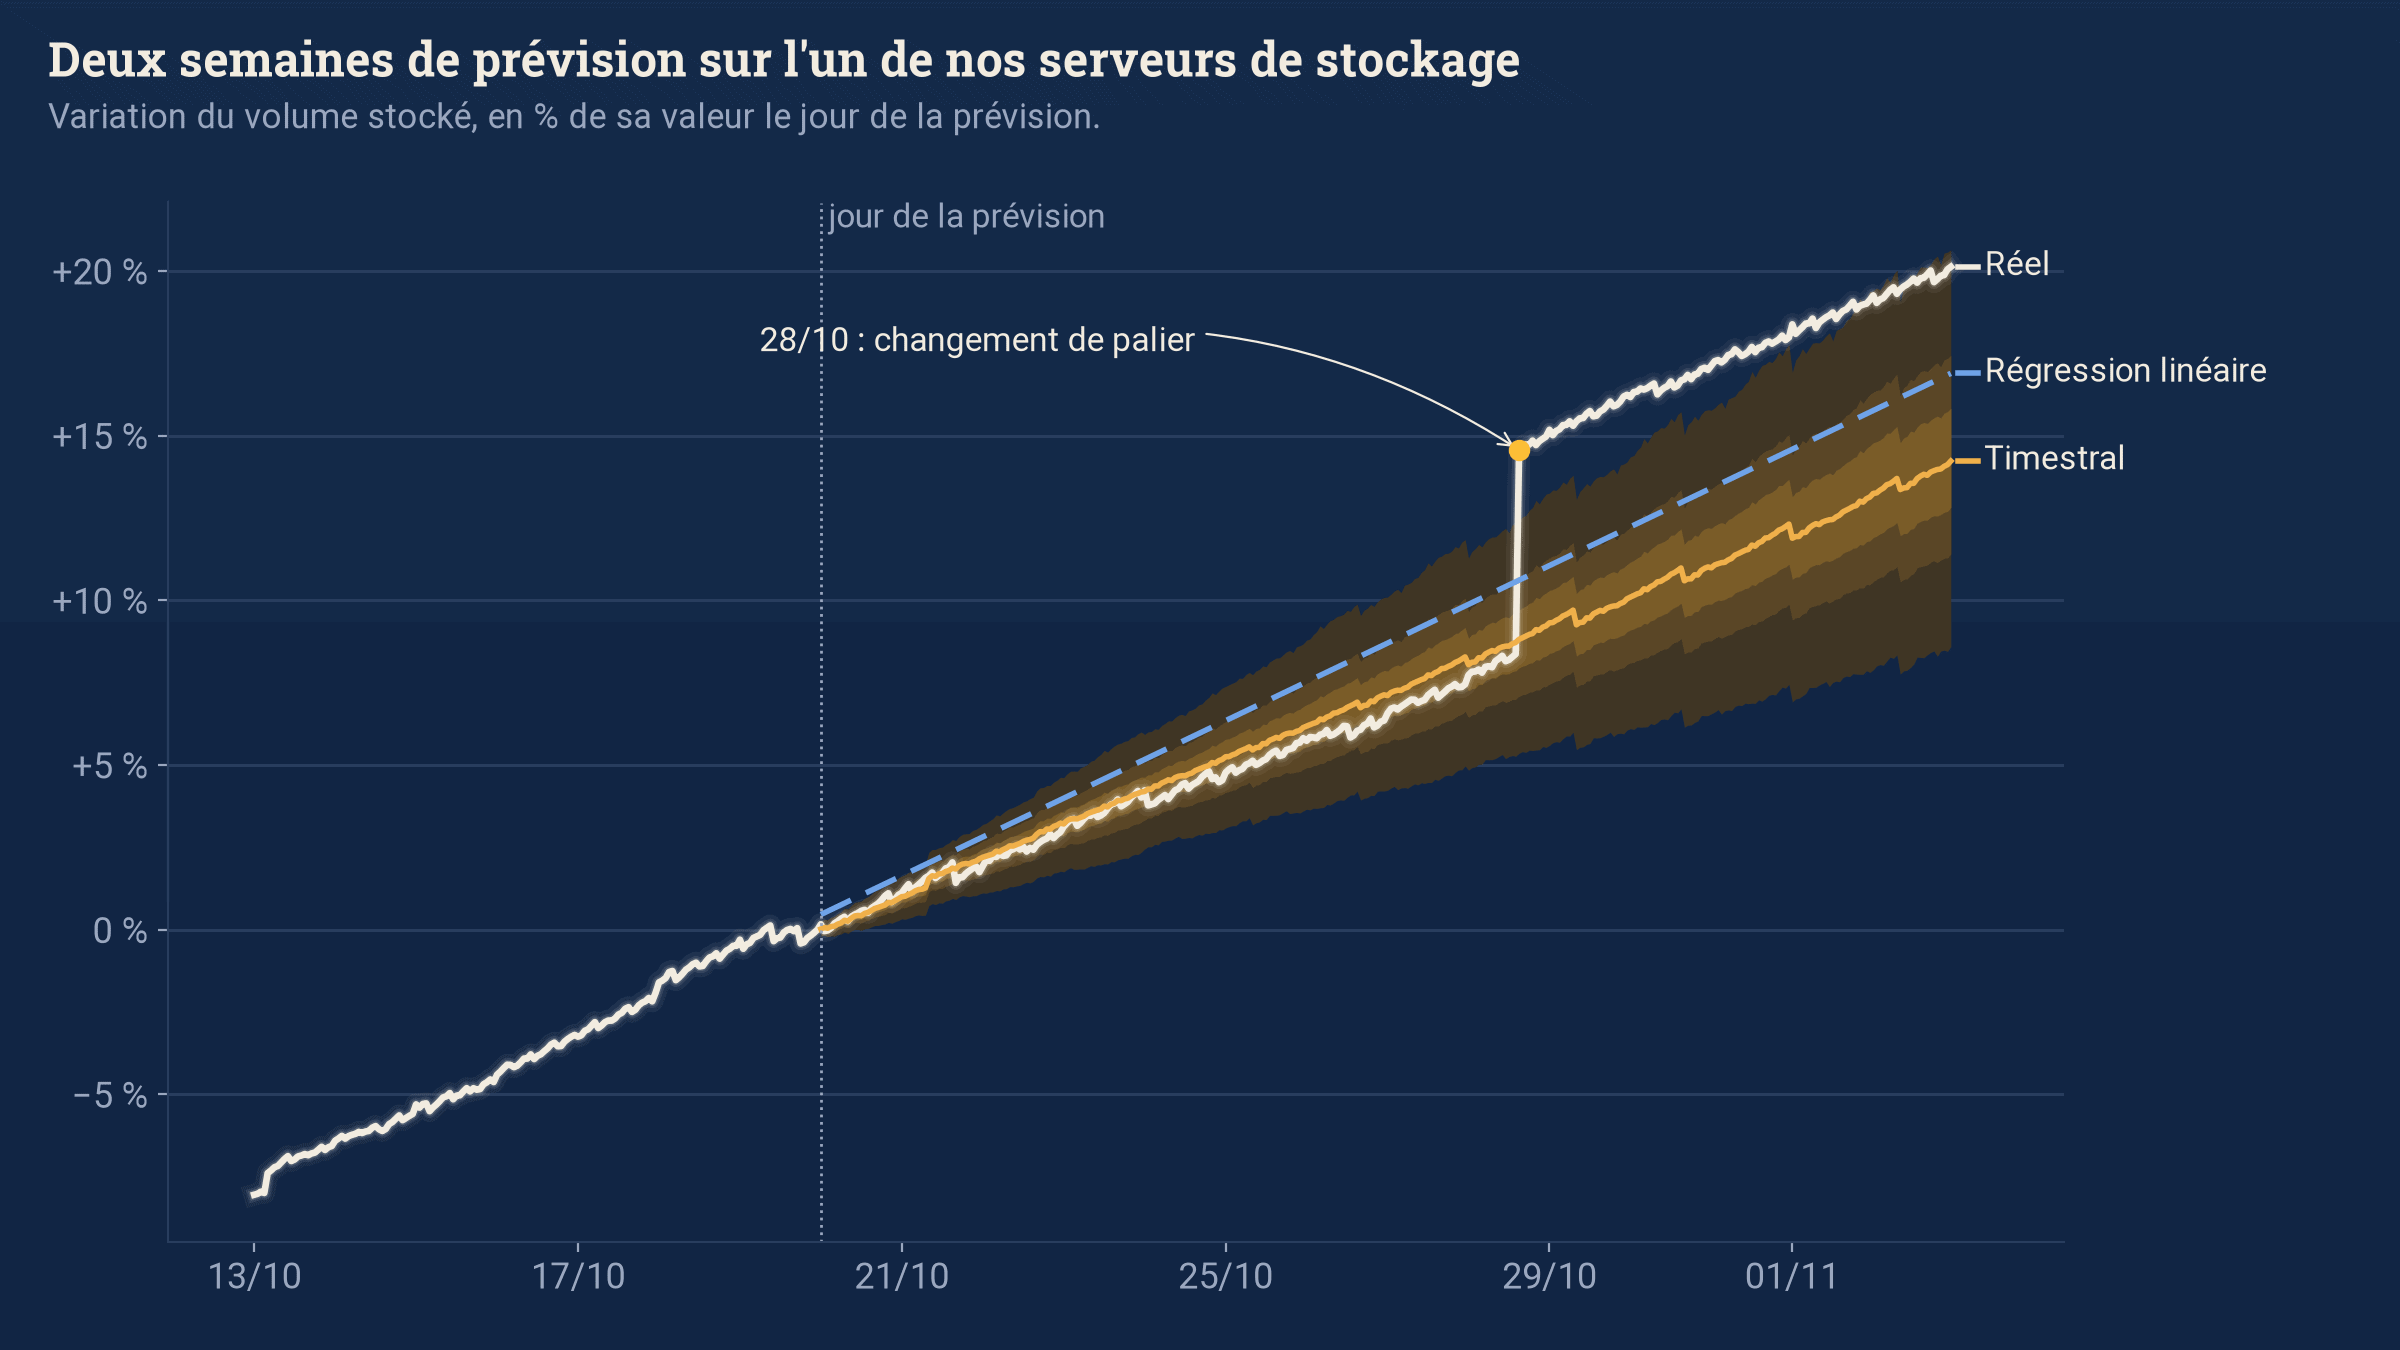
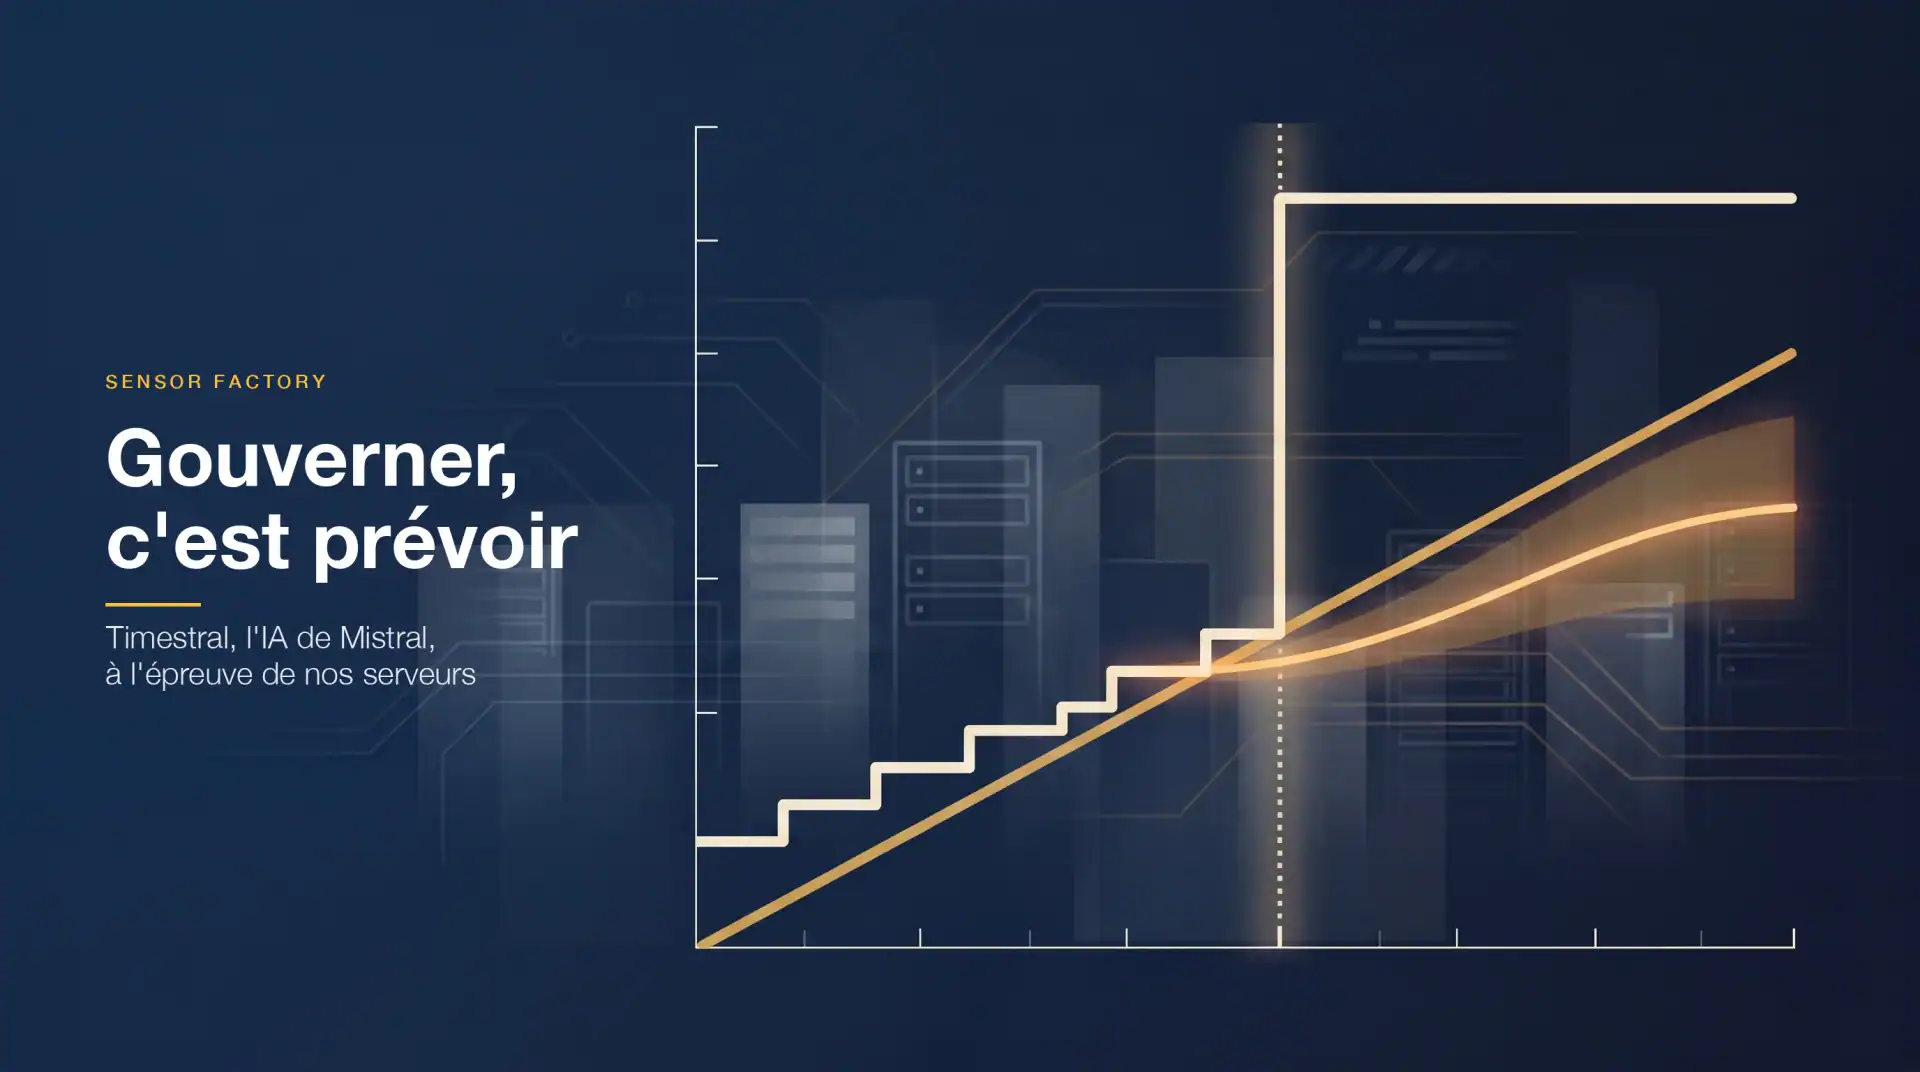
Ce scénario se retrouve dans toute DSI. Une nouvelle application passe en production, un site ouvre, une migration bascule des utilisateurs d’un serveur à l’autre : la consommation de ressources fait un saut que rien dans son historique n’annonçait. Les courbes ne montent pas en pente douce, elles progressent par paliers, et ces paliers expliquent l’essentiel des erreurs à sept jours. Un modèle ne peut pas les deviner. Les équipes qui préparent la mise en production, elles, les connaissent souvent des semaines à l’avance.
Timestral sait recevoir cette information. En plus de l’historique, il accepte des covariables connues à l’avance (known covariates), comme un calendrier de production ou des arrêts planifiés. Nous lui avons fourni le nombre de séries actives sur la période à prévoir, comme si le calendrier des mises en production avait été tenu à jour. Son erreur à sept jours a baissé de 8 % en moyenne, et de 15 % sur le débit d’écriture. Sur la prévision du lendemain, rien n’a changé.
Le gain reste modeste, et nous avons fourni au modèle les chiffres réels, ce qu’aucun planning ne garantit. Il indique pourtant où se trouve la marge de progrès : dans la connaissance de ce qui va arriver, plus que dans la puissance du modèle.
Ce que nous en retenons
Timestral est un bon modèle, rapide et peu coûteux à faire tourner, mais il ne remplace pas les méthodes existantes. Pour surveiller la saturation d’un stockage, la régression linéaire reste un bon choix, et elle est déjà disponible dans VictoriaMetrics, la base de séries temporelles que nous déployons chez nos clients. Les modèles comme Timestral trouvent leur place sur les métriques qui suivent un cycle, comme le trafic d’un site sur la semaine, et partout où l’on veut un intervalle de prévision fiable plutôt qu’un chiffre unique.
Notre test porte sur trois mois d’historique et sur le court terme, de un à sept jours. La planification des investissements à plusieurs mois est un autre exercice : elle demande plusieurs années d’historique, avec leurs cycles budgétaires et saisonniers.
La qualité d’une prévision dépend d’abord de ce que ni Mistral ni Amazon ne fournissent : des métriques collectées proprement et sans trou, le choix des séries qui méritent d’être prévues, une alerte réglée pour prévenir assez tôt sans réveiller l’astreinte à tort. C’est le travail que nous faisons chez nos clients, avec SenHub Agent pour la collecte et VictoriaMetrics pour le stockage, dont nous sommes partenaires revendeurs.
Gouverner, c’est prévoir. Sur nos serveurs, la meilleure piste pour mieux prévoir n’est pas venue du modèle le plus récent, mais du calendrier des mises en production.
Ce qu’il faut retenir – Pour surveiller la saturation d’un stockage, la fonction predict_linear de Prometheus et de VictoriaMetrics reste la bonne réponse. À une semaine, elle s’est trompée de 33 heures sur nos données, Timestral de 45. – Pour prévoir une métrique au jour le jour, Timestral apporte un vrai gain : une erreur inférieure de près d’un quart à celle de la régression linéaire, calculée sur un simple processeur. – L’essentiel des erreurs vient des paliers, comme la mise en production d’une nouvelle application, qu’aucun modèle ne devine. On gagne en précision en lui fournissant le calendrier des mises en production.
Si vous voulez savoir ce que la prévision peut apporter sur vos propres métriques, nous pouvons rejouer ce backtest sur vos données. Contactez-nous.
Pour les équipes techniques
Informations vérifiées au 3 novembre 2026.
Données. Sept séries horaires de consommation de ressources de notre infrastructure, du 3 août au 3 novembre 2026, sans trou : espace de stockage occupé sur deux serveurs, requêtes web, débit d’écriture, requêtes de lecture et d’écriture, et un compteur brut remis à zéro deux fois pendant la période de test.
Protocole. 28 origines quotidiennes à minuit UTC, horizon 24 h ; 6 origines hebdomadaires, horizon 168 h ; tout l’historique antérieur sert de contexte, aucun réglage par série. Erreur mesurée en MASE (erreur absolue moyenne rapportée à celle du naïf saisonnier sur 24 h, calculée sur le contexte), agrégée en moyenne géométrique.
Résultats à J+1 (MASE). Timestral-209M 0,27 ; Timestral-28M 0,27 ; régression sur 24 h 0,35 ; Chronos-2 0,45 ; régression sur 7 jours 0,78 ; répétition de la veille 0,98. Couverture de l’intervalle 10 %-90 % : 79 % pour Timestral-28M, 80 % pour Chronos-2. À J+7, la couverture de Timestral tombe à 63-67 % : sur nos séries en paliers, ses fourchettes à une semaine sont trop étroites.
Temps de calcul. Médiane par prévision sur Mac mini M4, 8 fils d’exécution, sans GPU : Timestral-28M 0,03 s, Chronos-2 0,07 s, Timestral-209M 0,18 s.
Saturation. 21 origines quotidiennes, deux nœuds, seuils fixés à la valeur réellement atteinte 24 h, 72 h et 168 h plus tard. Écart médian à 168 h : régression sur 7 jours 33 h, régression sur 24 h 41 h, Chronos-2 42 h, Timestral-28M 45 h. Toutes les méthodes sont en retard.
Covariable. Nombre de séries actives fourni comme covariable connue sur l’horizon, valeurs réelles. MASE à J+7 de 1,58 à 1,45 en moyenne, de 2,88 à 2,45 sur le débit d’écriture. Aucun effet à J+1.
Limites. Sept séries sur trois mois, dont la croissance procède par paliers. Les résultats ne valent pas pour toutes les infrastructures. Chronos-2 et Timestral ont été utilisés avec leurs réglages par défaut. Licence : code de Timestral sous Apache 2.0, poids sous licence MIT modifiée, gratuite sous 20 millions de dollars de chiffre d’affaires mensuel.
Sources. Annonce de Mistral ; article scientifique ; Chronos-2.